NASA и IBM создали модель искусственного интеллекта для исследования Луны
Организации также выпускают набор данных, который исследователи смогут использовать для создания собственных моделей.
Прошлой весной весь мир испытал редкое чувство общей радости и трепета, когда миссия NASA «Артемида II» (Artemis II), первый пилотируемый полет к Луне с 1972 года, успешно завершила исторический облет Луны. 6 апреля астронавты Рид Уайзмен, Кристина Кох, Виктор Гловер и Джереми Хансен удалились от Земли дальше, чем кто-либо из людей до них. Теперь, по мере того как NASA готовится к следующей миссии «Артемида» и дальнейшим исследованиям, космическое агентство работает совместно с IBM над тем, чтобы предоставить ученым новые инструменты для изучения естественного спутника Земли.
В четверг обе организации представили фундаментальную лунную модель NASA-IBM (NASA-IBM Lunar Foundation Model). Это система искусственного интеллекта с открытым исходным кодом, которую можно загрузить с платформы Hugging Face. По словам доктора Хуана Бернабе-Морено (Juan Bernabé-Moreno), директора IBM Research Europe в Великобритании и Ирландии, в качестве базовой модели она способна решать самые разные задачи. Прежде всего, NASA и IBM выяснили, что она особенно хорошо справляется с выявлением на лунной поверхности участков, где может находиться лед.
Организации провели тестирование, сравнив прогнозы модели с картой, созданной на основе опубликованного научного алгоритма, который учитывает рельеф, тепловые и другие экологические данные. Затем они столкнули модель с SwinV2-B — обученной Microsoft системой компьютерного зрения для обработки изображений высокого разрешения. Модель NASA-IBM сократила количество ошибок на 23 процента. NASA и IBM выбрали SwinV2-B для сравнения, так как этот инструмент часто используется в качестве базового для многих задач по анализу изображений.
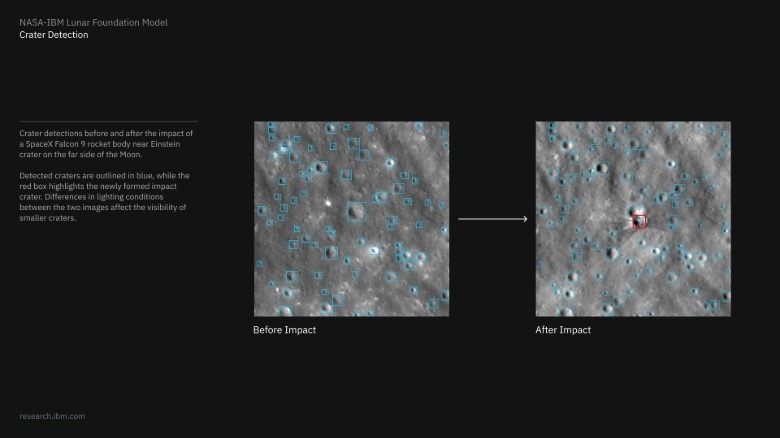
NASA и IBM также провели оценку способности своей модели распознавать и классифицировать кратеры. В этой задаче новая модель превзошла SwinV2-B на 19 процентов, используя при этом вдвое меньше обучающих данных. У NASA и IBM появилась возможность проверить способности модели на практике после того, как ракета SpaceX Falcon 9 упала на Луну 5 августа. Когда специалисты IBM передали модели снимок места падения, она правильно идентифицировала его как новый кратер, несмотря на то, что он сильно накладывался на уже существовавший ранее. «Это сработало фантастически», — отмечает Бернабе-Морено, добавляя, что модель безошибочно определила объект с первой же попытки.
По словам Бернабе-Морено, обучение модели было непростой задачей. «При наблюдении за Землей вы получаете четкие изображения», — поясняет он. Атмосфера нашей планеты рассеивает солнечный свет, заполняя тени рассеянным светом, который смягчает их границы. На Луне же тени выглядят резкими, как нож, и абсолютно черными, а это значит, что при любом их фотографировании затененные пиксели не несут никакой информации. «На Луне солнце находится в разном положении в течение дня, оно освещает и резко отсекает тени, и вам нужно работать с этими тенями», — говорит он. В результате один и тот же кратер может выглядеть определенным образом на одном снимке и совершенно иначе — на следующем.
Еще одна сложность была связана с тем, как обычно обучаются и тестируются модели компьютерного зрения. Чаще всего этот процесс заключается в удалении некоторых частей изображения с последующей задачей для модели реконструировать недостающие элементы на основе паттернов, изученных в ходе обучения. «Вы можете удалить 90 процентов кратера и попросить модель с помощью оставшихся 10 процентов восстановить остальные 90», — объясняет Бернабе-Морено. С Луной этот подход не работает. Как нетрудно догадаться, причина в том, что при съемке с орбиты множество кратеров выглядят очень похожими друг на друга.
Фактически, попытки IBM обучить модель традиционным способом обернулись «полной катастрофой», рассказывает Бернабе-Морено, но в итоге исследовательская команда нашла креативное решение. «Мы взяли Луну и разделили ее на сегменты, как апельсин, полностью отделив тренировочные сегменты от тестовых. Таким образом мы смогли обеспечить высокую степень согласованности данных для модели», — говорит он.
Одна из причин, почему NASA и IBM так воодушевлены этим релизом, заключается в том, что он включает в себя первый в своем роде набор данных с открытым исходным кодом, который другие исследователи смогут использовать для создания будущих моделей. Он объединяет десятки тысяч изображений и данных приборов с аппаратов NASA Lunar Reconnaissance Orbiter (LRO) и Gravity Recovery and Interior Laboratory (GRAIL), а также японского зонда SELENE (Selenological and Engineering Explorer).
«Одна из причин, почему у нас никогда раньше не было комплексной и мощной лунной модели, заключалась в том, что данные не были организованы должным образом», — отмечает Бернабе-Морено. Организация данных в данном случае означала создание координатной сетки, в которой каждый пиксель изображения соответствует другим типам данных, которые модель может использовать для обработки. «Уже сам по себе этот шаг — огромный научный вклад, ведь если отбросить саму модель, теперь научное сообщество располагает зарегистрированным набором данных, содержащим более двух миллионов точек, — подчеркивает Бернабе-Морено. — И мы знаем, что модели ИИ со временем сменяют друг друга. Именно данные по-настоящую создают индустрию искусственного интеллекта».